Industrialisation des flux de données d’une multinationale grâce à dbt et Airflow.
Comment industrialiser les pipelines de données avec Airflow et dbt pour accompagner la montée en charge et l’évolution des besoins Data d’une multinationale.
 Codéin
17/08/2026
Eléments clés
- Problématique : Industrialiser et uniformiser une architecture Data devenue progressivement fragmentée au fil de l’évolution des besoins, tout en retranscrivant des logiques métier complexes existantes. L’enjeu est de rendre les traitements plus lisibles, maintenables et évolutifs, dans un environnement on-premise imposant de fortes contraintes de maîtrise et de sécurité des données.
- Objectif : Reconstituer et documenter les logiques existantes grâce à un travail de rétro-ingénierie, puis bâtir une architecture ouverte et maîtrisée. L’objectif est de standardiser les flux, de fiabiliser les traitements et de faciliter l’intégration de nouveaux cas d’usage sans repartir de zéro à chaque fois.
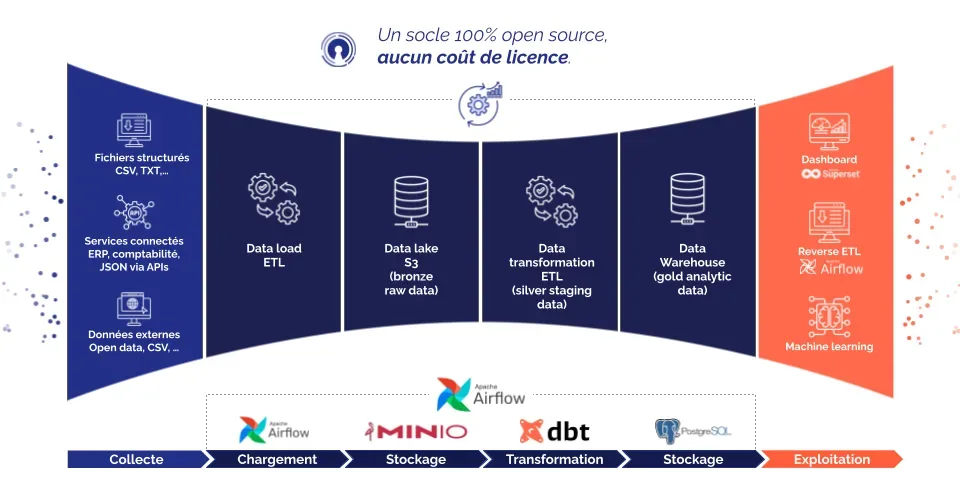
- Solution : Construire une architecture reposant sur des technologies Open Source, organisée autour d’un Data Lake Apache Iceberg, d’un Data Warehouse PostgreSQL, de dbt pour les transformations et d’Apache Airflow pour l’orchestration. Le projet s’inscrit dans une logique « Data as Code » afin de rendre les traitements versionnables, testables et réutilisables.
Contexte et enjeux
Murata est un groupe japonais spécialisé dans la conception et la production de composants électroniques. Le groupe développe entre autres son activité via une filiale implantée à Caen. Cette évolution s’accompagne d’une augmentation des besoins liés à la donnée pour cette dernière.
Construite progressivement au fil des usages, l’architecture Data devait désormais être uniformisée et industrialisée pour répondre aux nouveaux besoins. L’enjeu : mieux maîtriser les logiques métier existantes, standardiser les traitements et disposer d’un socle suffisamment robuste pour supporter une volumétrie plus importante et de nouveaux flux.
Le projet implique également un travail de rétro-ingénierie afin de retranscrire les règles métier existantes dans une architecture plus lisible, maintenable et évolutive. L’ensemble de ce travail doit aussi respecter les contraintes d’un environnement on-premise pour maintenir un contrôle total sur la sécurité des données.
Choix du partenaire et de la solution mise en place
La nécessité d’un environnement on-premise a orienté le projet vers des technologies Open Source permettant de conserver la maîtrise totale du code, de l’architecture et des données.
- un Data Lake avec Apache Iceberg pour stocker les données brutes
- un Data Warehouse PostgreSQL pour stocker les données transformées
- Apache Airflow pour orchestrer les traitements
- dbt pour modéliser et transformer les données
dbt pour structurer la transformation
Les données suivent plusieurs niveaux de transformation :
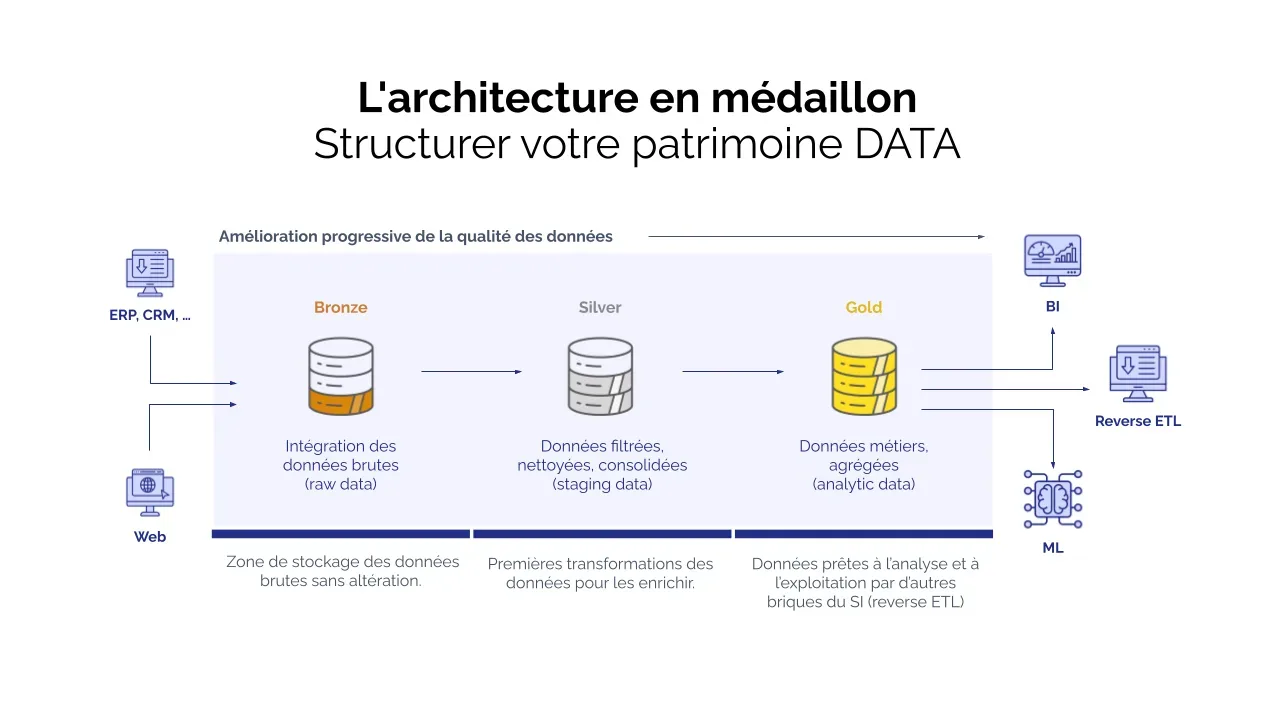
Sources → Inbound → Staging → Datamart, correspondant à une architecture en médaillon. Les données sont progressivement transférées, contrôlées, transformées, puis mises à disposition des métiers.
Ces logiques sont validées par des tests unitaires et d’intégration automatisés.
Airflow pour organiser les flux
Apache Airflow orchestre l’exécution des traitements et permet de standardiser l’organisation des différents pipelines.
Une structure commune peut être déclinée en différentes fréquences, règles métier ou stratégies de retry. Airflow offre aussi une visibilité globale sur l’état du système et a déjà démontré sa capacité à gérer plusieurs milliers de flux simultanément.
“Data as Code” pour optimiser la maintenance
Toutes les solutions utilisées déclarent l’ensemble de leurs processus sous forme de code et de fichiers texte. Il est alors possible de structurer les flux et transformations en composants modulaires versionnés, afin de faciliter leur maintenance, leur évolution et leur réutilisation.
Témoignage
Lucas, Léo et moi-même avons particulièrement apprécié notre collaboration avec Codéin, fondée sur des échanges de qualité, une grande transparence et une réelle compréhension de nos enjeux métiers. Leur expertise et leur capacité à s’approprier rapidement notre contexte de travail, associées à une gestion de projet efficace, ont permis de construire une relation de confiance et un véritable partenariat.
Déroulement du Projet
Le projet s’est organisé en deux phases :
POC de 20 jours pour tester et valider les choix techniques :
- Construction de l’environnement de développement
- Conception de l’architecture principale Data Lake + Data Warehouse PostgreSQL
- Développement et industrialisation d’un pipeline pilote avec dbt + Airflow, de la collecte jusqu’aux données métiers qualifiées
- Validation des choix techniques et de la solution proposée
Poursuite en régie – 20 jours/mois :
- Montée en charge de la nouvelle architecture en intégrant de nouveaux flux plus complexes
- Fiabilisation du pipeline via l’automatisation des tests en CI/CD
- Validation rigoureuse de la qualité des données de la nouvelle architecture pour ne pas impacter les utilisateurs finaux
Résultats et prochaines étapes
Industrialisation et modernisation de flux de données existants
- Conception et validation d'une architecture hybride Data Lake + Data Warehouse
- Organisation des traitements selon un pipeline standard : Sources → Inbound → Staging → Datamart
- Mutualisation des processus au sein d’une codebase unique reposant sur une stack technique unifiée et des composants modulaires et réutilisables
- Standardisation du processus d’intégration de nouveaux flux de données à la nouvelle plateforme
Quelles prochaines étapes ?
- Intégration de flux supplémentaires au sein de la nouvelle architecture
- Industrialisation de la partie Visualisation des données
- Renforcement des processus qualités en développant les processus de CI/CD
- Évaluation et optimisation des performances à chaque étape
Bonnes pratiques
- Appliquer la rigueur du test logiciel aux transformations des données via les tests dbt. Cela augmente la confiance dans la nouvelle implémentation et sécurise la suite du développement contre les régressions
- Automatiser les processus en CI/CD tôt dans le développement
- Penser montée en charge dès la conception. Les chargements différentiels (tables incrémentales dbt) ne traitent que les données nouvelles ou modifiées, ce qui améliore les performances et permet d'absorber l'augmentation des volumes sans refonte.
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !
Vous devez être connecté pour ajouter un commentaire.
Daté au niveau du modèle
- À revoir le
- 25/03/2027
Electronics manufacturing
Tags
REX produit par
Images du projet